KI-Agenten brauchen Leitplanken: Erfahrungen aus einer VB6-Migration
Dass KI-Agenten Code schreiben können, ist keine Neuigkeit mehr. Spannender ist, wie sich ein Großteil der Entwicklungsarbeit an sie übergeben lässt, ohne die Kontrolle über die Qualität zu verlieren. Dieser Frage sind wir bei der Migration eines Moduls in einem Kundenprojekt nachgegangen: Die bestehende VB6-Anwendung (Visual Basic 6; im Folgenden: das Original) sollte möglichst verhaltensgleich nach C# übertragen werden (der Port). Der Auftraggeber hatte sich dabei ausdrücklich einen möglichst weitgehend agentengetriebenen Ansatz gewünscht. Im Mittelpunkt standen zwei Bausteine: eine ausführbare Spezifikation und ein GitHub-Workflow, der die Agenten Schritt für Schritt führt.
Die Spezifikation als Leitplanke
Die initialen fachlichen Anforderungen kamen vom Kunden; jede davon ist als Szenario in (fachlich lesbarer) Robot-Framework-Notation beschrieben: Was wird eingegeben, und was muss danach auf dem Bildschirm, im Ausdruck oder in der Zwischenablage stehen? Aus jedem Szenario erzeugen wir automatisch zwei Dinge – einen C#-Test, der die echte Oberfläche im Browser bedient, und eine Seite lebender Dokumentation mit Screenshots und Video. Spezifikation, Test und Dokumentation können auf diese Weise gar nicht erst auseinanderlaufen.
Jede Anforderung hat einen sichtbaren Status; ein fehlschlagender (roter) Test dokumentiert dabei offene Arbeit und dient damit als Arbeitsauftrag für die Agenten. Der Build wird dadurch nicht blockiert.
Agenten im GitHub-Workflow
Die Steuerung der Arbeit fand mithilfe von GitHub-Issues statt; die einzelnen Stationen, an denen jeweils ein KI-Coding-Agent die Bearbeitung übernahm, wurden über Labels abgebildet. Die folgende Skizze zeigt den Ablauf im Projekt.
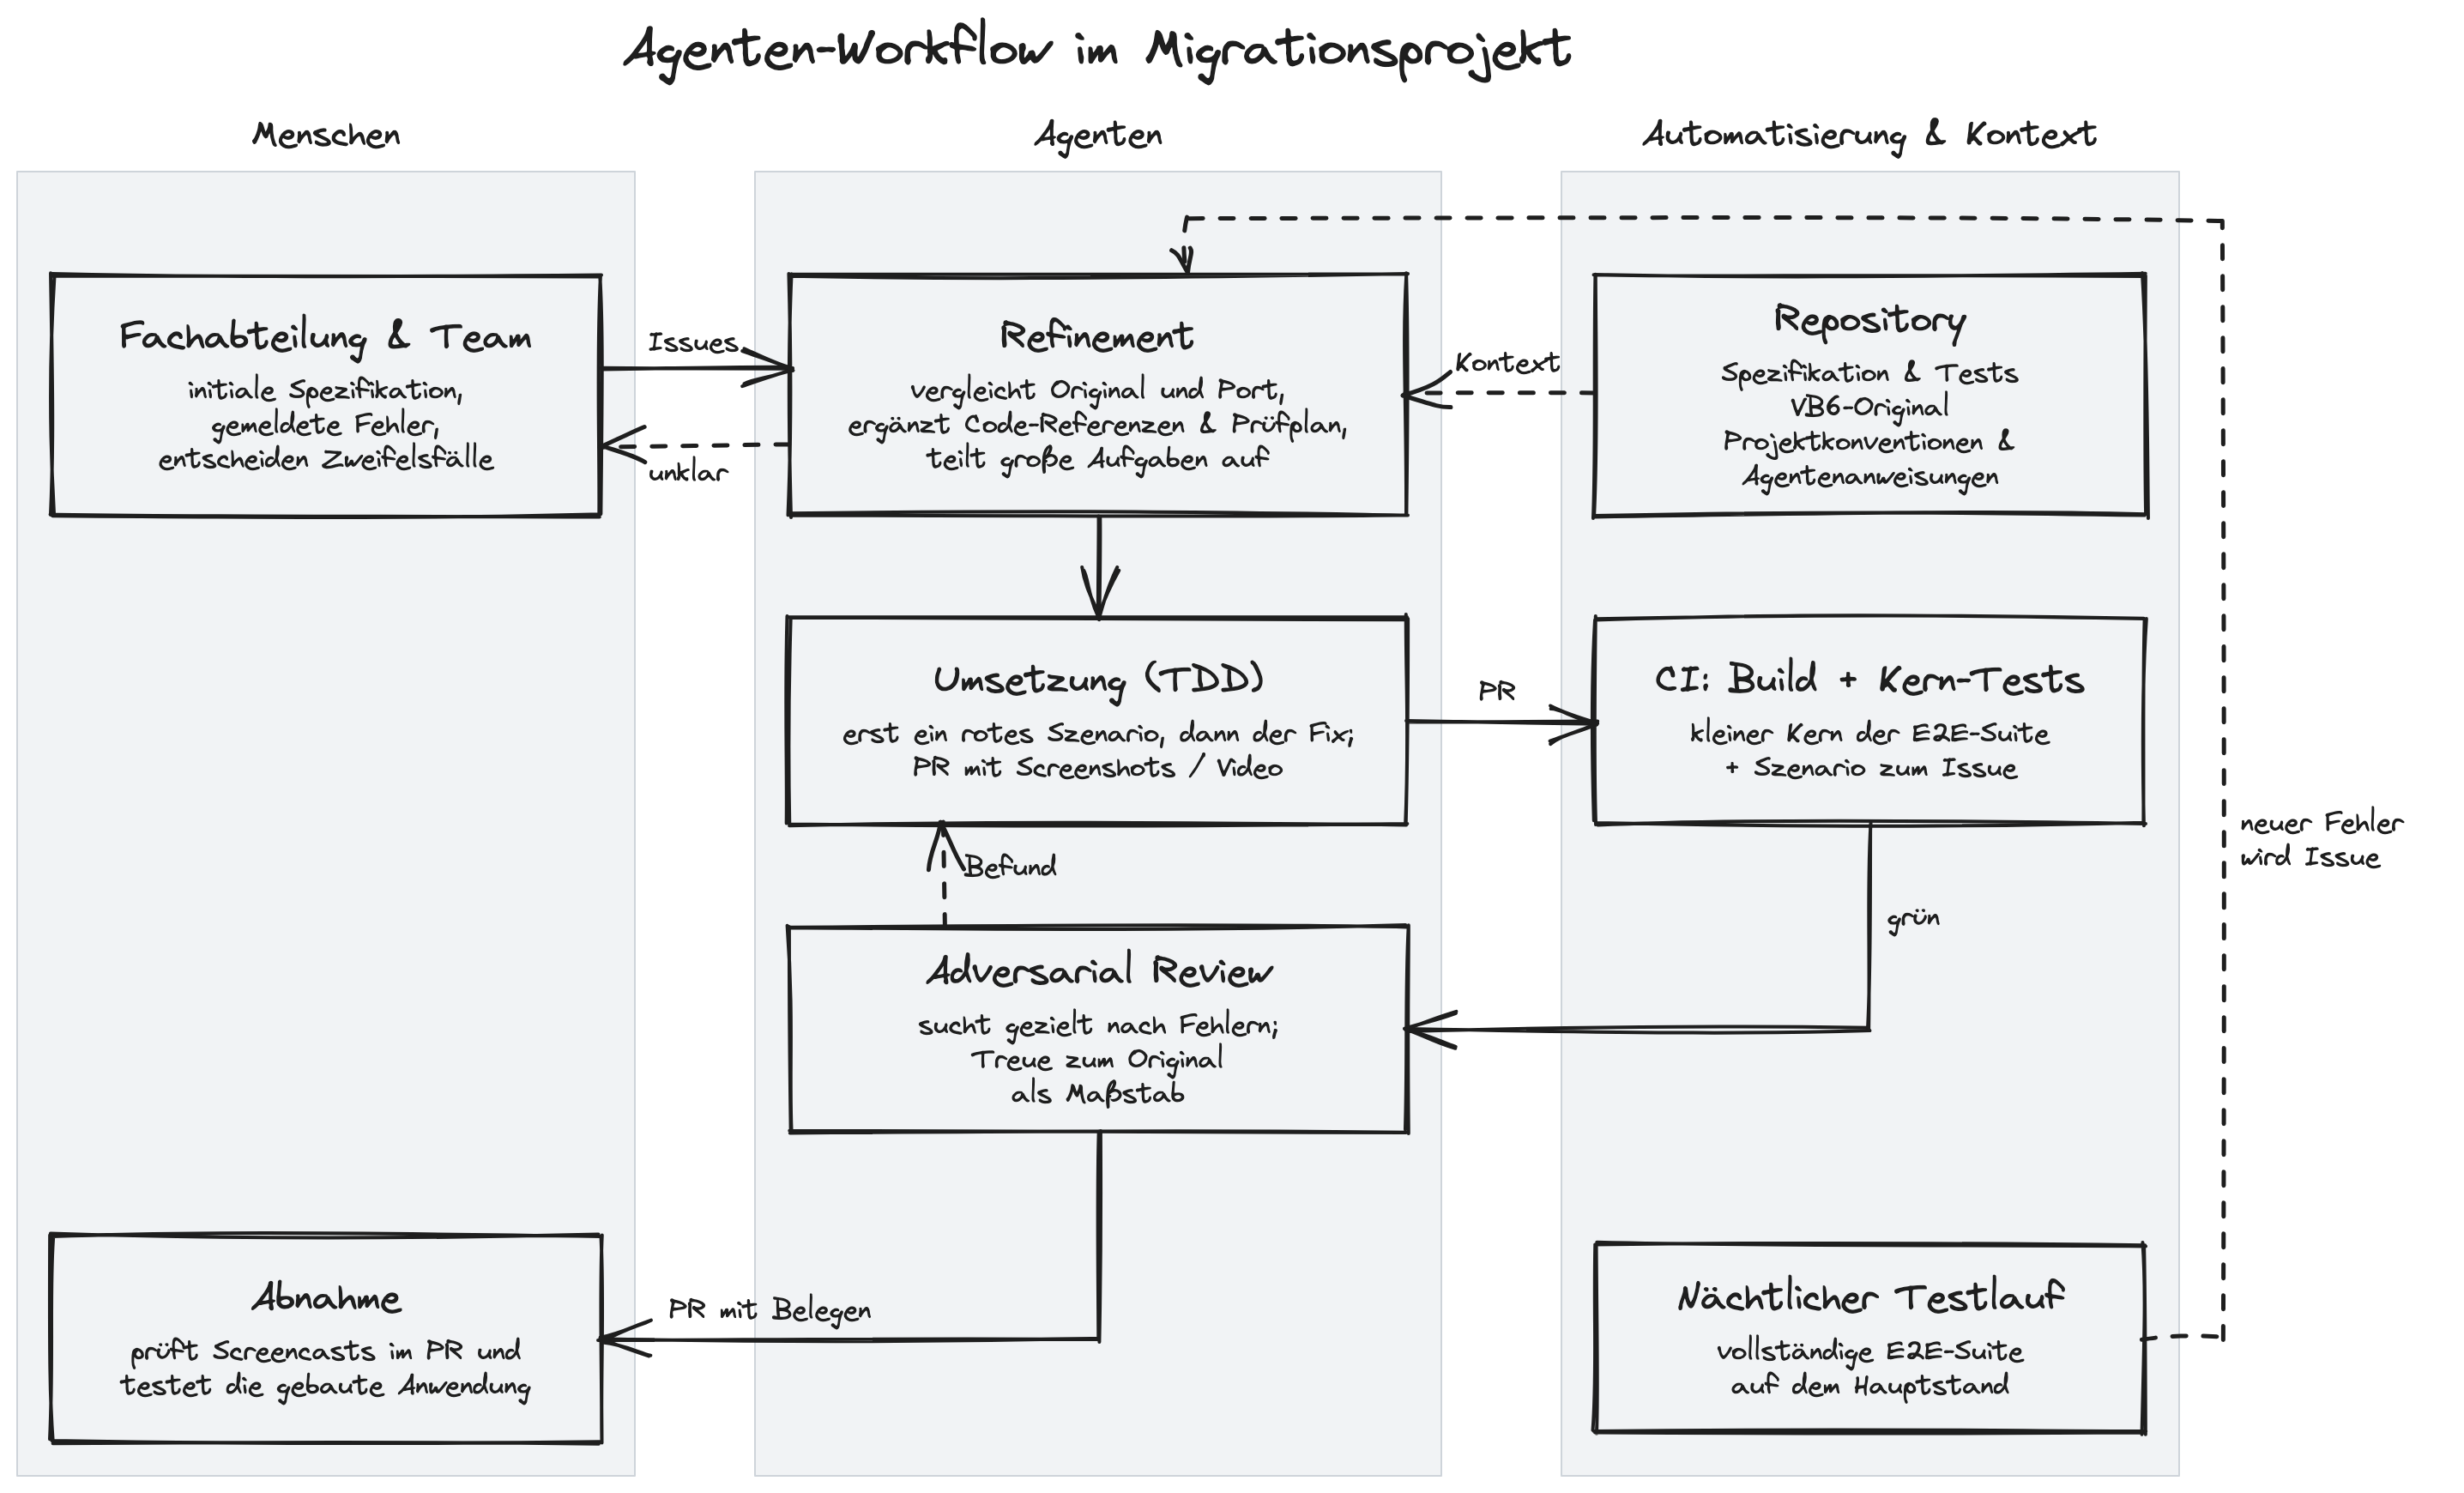
- Refinement: Ein Agent vergleicht Original und Port im Quellcode. Er ergänzt Code-Referenzen sowie einen Prüfplan und teilt zu große Aufgaben auf.
- Umsetzung: Ein zweiter Agent arbeitet testgetrieben (TDD, Test-Driven Development): erst ein Szenario, das nachweislich fehlschlägt, dann die Korrektur. Das Ergebnis wird im Pull Request (PR) mithilfe von Screenshots oder einem Video nachvollziehbar belegt.
- Adversarial Review: Ein dritter Agent sucht gezielt nach Fehlern (oberstes Kriterium: Treue zum Original). Findet er etwas, geht das Issue zurück in die Umsetzung.
Da die End-to-End-Tests (E2E) aufwendig sind, lief pro Pull Request in der Continuous Integration (CI) nur ein kleiner Kern davon (plus das Szenario zum Issue); die vollständige Test-Suite lief nachts und legte neue Fehler als Issues an. Menschen legen dabei fest, was gebaut wird – über die initialen Anforderungen des Kunden und über gemeldete Fehler, die als Issues einflossen. Lässt sich das erwartete Verhalten aus dem Original nicht eindeutig ableiten, wird das Issue zurückgestellt, bis eine Entscheidung durch einen Menschen vorliegt.
Was wir mitgenommen haben
- Agenten brauchen ein überprüfbares „fertig“. Ein Test, der vorher rot und danach grün ist, macht das Ergebnis objektiv überprüfbar.
- Die Prüfung von KI-Ergebnissen erfolgt anhand von Belegen. Screenshots und Videos machen Reviews schneller und besser nachvollziehbar; Zusammenfassungen der Agenten allein genügen dafür nicht.
- Kontext gehört ins Repository. Projektkonventionen und Agentenanweisungen liegen versioniert neben dem Code – so arbeitet jeder Lauf im selben Rahmen.
- Eine gezielte Fehlersuche deckt mehr Probleme auf als eine generische Prüfung. Das gilt für Agenten ebenso wie für Menschen.
Was gefehlt hat
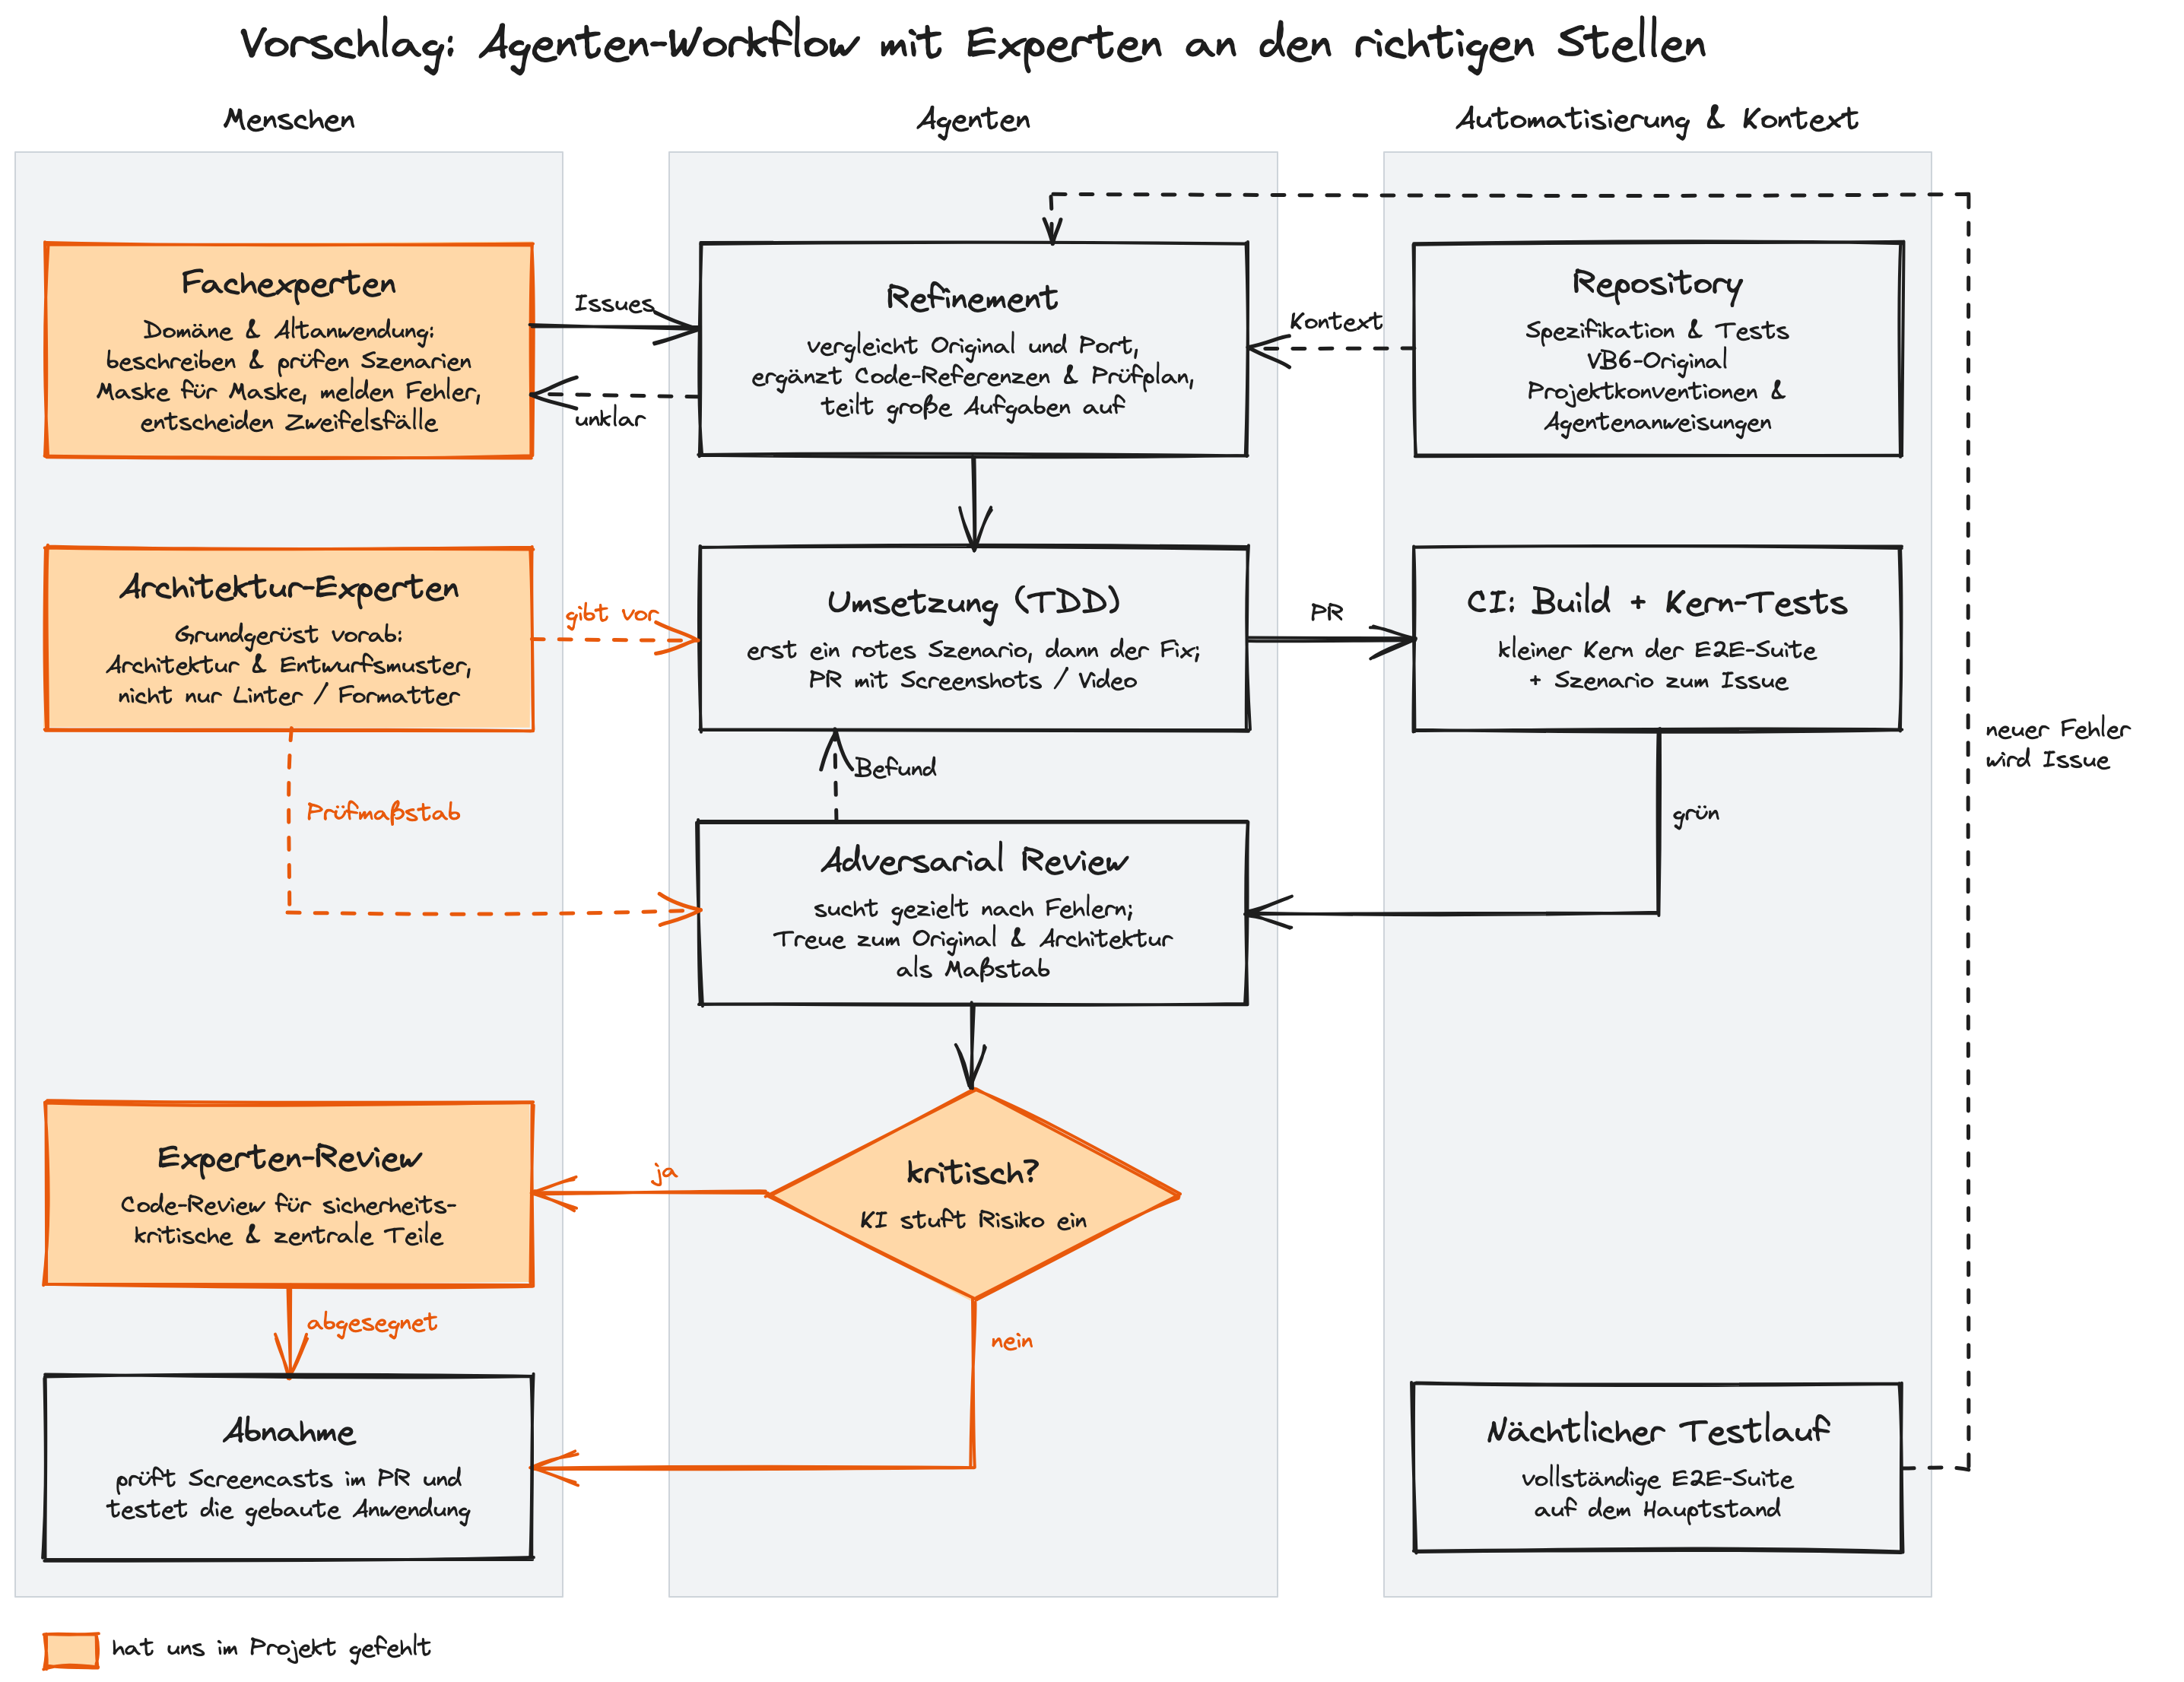
So weit, so gut. Rückblickend fehlten dem Ansatz allerdings die folgenden drei Bausteine, bei denen Agenten Fachleute nicht ersetzen können (und auch nicht sollten).
- Ein Architektur-Grundgerüst von Anfang an. Nicht nur Linter und Formatter, sondern tragende Entscheidungen zu Architektur und Entwurfsmustern als Maßstab für Agenten und Reviews. Shopify macht es mit seinem Migrationswerkzeug Helix vor: Dort prüft jedes Review gegen eine vorab dokumentierte Architektur.
- Tiefere Szenarien. Fachexperten und Kenner der Altanwendung sollten jede Maske gründlich beschreiben und die Pläne der Agenten prüfen – so wie bei der Migration der Shopify-Shop-App, wo das Softwareentwicklungsteam Anforderungen und Pläne vor der Umsetzung prüfte und Feature-Teams ihre Randfälle validierten.
- Expertenreview, wo es zählt. Sicherheitskritische und zentrale Teile brauchen die Freigabe durch Menschen. Die KI kann helfen, diese Stellen zu finden: Meta stuft mit RADAR jede Änderung nach Risiko ein und leitet die riskanten an menschliche Reviewer weiter.
Die folgende Skizze zeigt, wie ein solcher Prozess aussehen könnte; orange markiert ist, was uns im Projekt gefehlt hat.
Viele Ideen aus diesem Projekt entwickeln wir seitdem weiter. Die wichtigste Erkenntnis ist dabei vielleicht gar nicht so überraschend: KI beschleunigt vor allem dort, wo der Prozess klare Leitplanken setzt. Welche das sind, muss sich (wie so oft) im jeweiligen Projekt erst finden.
Genau dabei unterstützen wir gerne auch andere Teams – und schauen gemeinsam, wo KI einen echten Unterschied macht und wo eben nicht. Das geht unabhängig von der eingesetzten Technologie; unser eigenes Expertenwissen liegt dabei vor allem in der Entwicklung mobiler Anwendungen und Webanwendungen.